vLLM — AI 서버 관리
최신 도구 가이드 / AI 서버 관리 / vllm.html
GPU 기반 고성능 LLM 추론·서빙 엔진
기본 정보
| 프로그램 이름 | vLLM (브이엘엘엠) |
|---|---|
| 한 줄 소개 | GPU 기반 고성능 LLM 추론·서빙 엔진 |
| 개발·유지 | vLLM Project (LF AI & Data) |
| 공식 홈페이지 | https://vllm.ai/ |
| 공식 문서 | https://docs.vllm.ai/ |
| 공식 다운로드 | https://docs.vllm.ai/en/latest/getting_started/installation.html |
| 지원 운영체제 | Linux (NVIDIA CUDA, AMD ROCm, TPU 등) |
| 라이선스 | Apache-2.0 라이선스 |
| 안정 버전 | v0.31.0 (2026-10-05 공식 GitHub 릴리스 기준) — 확인일 2026-10-18 |
| GitHub 저장소 | https://github.com/vllm-project/vllm |
| 분류 | AI 서버 관리 (태그: AI, LLM 서빙, GPU, 추론, 프로덕션) |
이 프로그램은 무엇인가?
vLLM은 대규모 언어 모델을 프로덕션 환경에서 높은 throughput으로 서빙하기 위한 추론 엔진입니다. PagedAttention이라는 기술로 KV 캐시 메모리를 페이지 단위로 관리해 메모리 파편화를 크게 줄이고, 연속 배칭으로 여러 요청을 효율적으로 묶어 처리합니다.
OpenAI 호환 API 서버를 제공하므로, 기존 OpenAI 클라이언트는 base URL만 바꿔 vLLM 서버로 연결할 수 있습니다. 다중 사용자 챗봇, 코드 생성 서비스, 에이전트 백엔드처럼 동시 요청이 많은 서비스에 적합합니다.
어떤 문제를 해결하는가?
- 여러 사용자가 동시에 LLM을 호출할 때 높은 throughput이 필요한 상황
- GPU 메모리를 최대한 활용해 더 큰 모델이나 더 많은 세션을 처리해야 하는 상황
- OpenAI API와 호환되는 자체 서빙 인프라를 구축해야 하는 상황
주요 기능
PagedAttention
KV 캐시를 페이지 단위로 관리해 메모리 낭비 최소화
- 활용 상황: GPU 메모리에서 더 많은 세션 유지
- 얻는 결과: 동시 세션 수 증가, throughput 향상
- 제한 사항: 설정에 따라 성능 특성이 달라짐
연속 배칭
요청이 도착하는 대로 배치에 동적으로 합류
- 활용 상황: 대기 시간과 처리량의 균형 개선
- 얻는 결과: 지연 시간 관리하면서 throughput 확보
- 제한 사항: 배치 크기 튜닝이 필요할 수 있음
OpenAI 호환 API
OpenAI Chat Completions 형태의 엔드포인트 제공
- 활용 상황: 기존 앱 코드 수정 없이 전환
- 얻는 결과: 클라이언트 재사용 가능
- 제한 사항: 일부 세부 기능 차이가 있을 수 있음
다양한 모델 지원
Hugging Face 가중치와 다양한 양자화 형식 지원
- 활용 상황: 최신 오픈 가중치 모델 배포
- 얻는 결과: 광범위한 모델 호환
- 제한 사항: 모델별 호환성 문서 확인 필요
설치 및 실행
pip (Python 환경)
Python 가상환경에서 pip로 설치합니다. CUDA 등 가속기 환경이 필요합니다.
pip install vllmDocker
공식 컨테이너 이미지로 배포합니다. GPU 런타임이 필요합니다.
docker run --gpus all -v ~/.cache/huggingface:/root/.cache/huggingface -p 8000:8000 vllm/vllm-openai:latest --model <모델명>실제 사용 예제
OpenAI 호환 서버 시작
Hugging Face 모델명을 지정해 서버를 띄웁니다.
vllm serve meta-llama/Llama-3.3-70B-Instruct --port 8000요청 전송
OpenAI 클라이언트나 curl로 추론 요청을 보냅니다.
curl http://localhost:8000/v1/chat/completions -d '{"model":"meta-llama/Llama-3.3-70B-Instruct","messages":[{"role":"user","content":"hello"}]}'GPU 리소스 확인
서버 로그에서 GPU 메모리·배치 상태를 확인합니다.
docker logs <컨테이너명> | tail -20장점과 한계
장점
- 동시 요청 환경에서 높은 throughput 제공
- OpenAI 호환 API로 기존 생태계 재사용
- Apache-2.0 라이선스로 자유로운 사용
- NVIDIA·AMD·TPO 등 다양한 가속기 지원
사용 전에 고려할 점
- GPU 환경 설정과 드라이버 관리가 필요
- 소규모·단일 사용자 시나리오에는 과잉 사양일 수 있음
- 최신 모델 지원을 위해 자주 업데이트해야 함
비슷한 프로그램과 비교
| 프로그램 | 특징 | 이런 경우에 적합 |
|---|---|---|
| Ollama | 설치·실행이 간단한 로컬 LLM 런타임 | 개인 개발·소규모 테스트 |
| TGI (Text Generation Inference) | Hugging Face 추론 서버(업스트림 유지보수 모드) | 안정적인 기존 배포 유지 |
| NVIDIA Triton | 범용 추론 서빙 플랫폼(LLM 외 다중 모델) | 여러 종류 모델을 한 서버에서 서빙 |
공식 자료 및 추가 학습
- 공식 홈페이지 — https://vllm.ai/
- 공식 문서 / 지식베이스 — https://docs.vllm.ai/
- 공식 다운로드 — https://docs.vllm.ai/en/latest/getting_started/installation.html
- 릴리스 노트 — https://github.com/vllm-project/vllm/releases
- 소스 / 개발 자료 — https://github.com/vllm-project/vllm
버전·지원 환경 정보는 2026-10-18 기준으로 공식 사이트에서 확인한 값입니다. 설치 명령은 사용하는 배포판과 버전에 따라 달라질 수 있으므로 공식 설치 문서를 함께 확인하세요.
실제 실행 화면
합성 예시 — 실제 실행 결과가 아닙니다. 화면은 합성 예시이며 실제 실행 결과가 아닙니다.
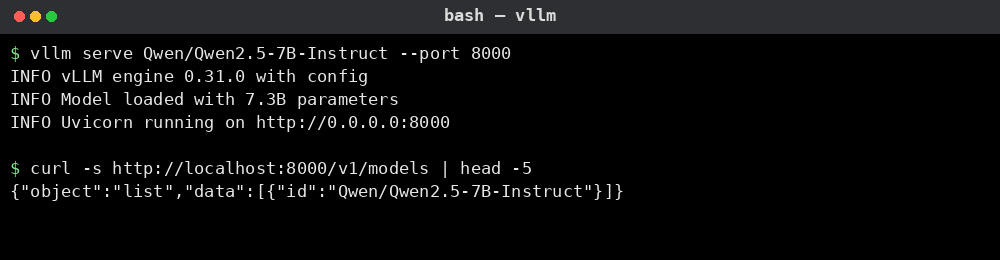
실제 운영 중인 서버
이 문서는 화면 표시용 가상 디렉터리의 항목입니다. 실제 서버 파일시스템과 연결되지 않으며, 파일 실행이나 시스템 명령을 수행하지 않습니다.